
Duración: 20 horas
Objetivo general: El objetivo de este curso es proporcionar a los participantes los conocimientos y habilidades necesarias para desarrollar soluciones de Ciencia de Datos y Machine Learning utilizando Microsoft Fabric, comprendiendo el ciclo completo desde la preparación y exploración de los datos hasta el entrenamiento, experimentación, gestión, automatización y consumo de modelos analíticos.
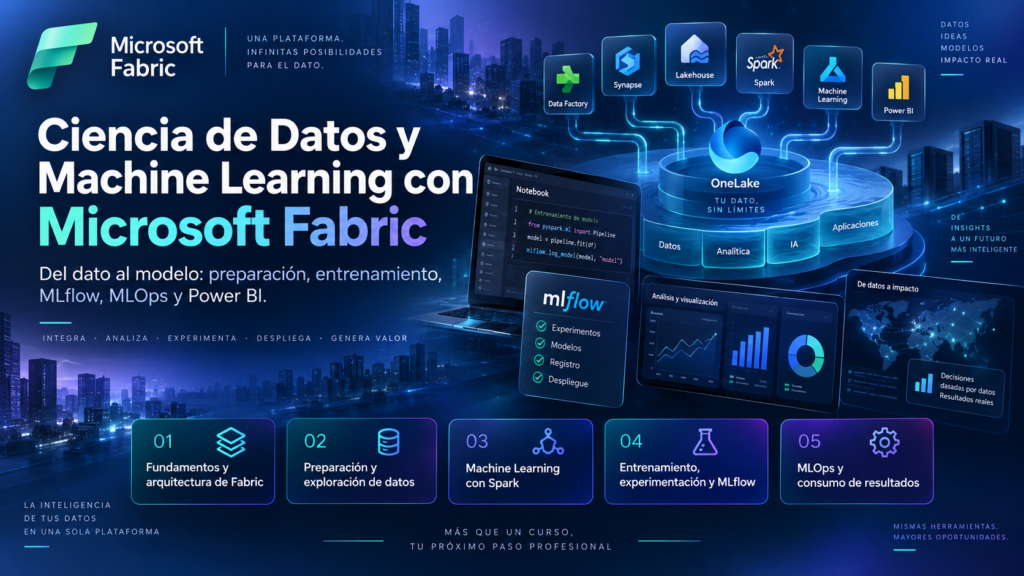
Módulo 1. Introducción a Ciencia de Datos y Microsoft Fabric
Descripción
Este módulo introduce los conceptos fundamentales de Ciencia de Datos y presenta Microsoft Fabric como plataforma unificada para desarrollar soluciones de analítica avanzada, Machine Learning e Inteligencia Artificial.
Los participantes conocerán los principales componentes de la plataforma, la arquitectura general de Fabric y la forma en que se integran OneLake, Lakehouse, notebooks, Data Science y Power BI dentro de una solución analítica.
Temas a cubrir
- Fundamentos de Ciencia de Datos, analítica avanzada y Machine Learning.
- Arquitectura y principales componentes de Microsoft Fabric.
- OneLake, Lakehouse, Workspaces y notebooks.
- Flujo general de una solución de Ciencia de Datos en Microsoft Fabric.
Módulo 2. Preparación y exploración de datos para Ciencia de Datos
Descripción
Este módulo aborda la preparación de información necesaria para desarrollar soluciones de Ciencia de Datos. Se trabajará con datos almacenados en Microsoft Fabric utilizando notebooks, Python y PySpark para realizar procesos de limpieza, transformación, análisis exploratorio y preparación de variables.
El objetivo es generar conjuntos de datos confiables y adecuados para el entrenamiento posterior de modelos de Machine Learning.
Temas a cubrir
- Ingesta, transformación y preparación de datos en Lakehouse.
- Análisis exploratorio y evaluación de calidad de los datos.
- Uso de Python, PySpark y DataFrames en notebooks de Fabric.
- Feature Engineering y preparación de datasets para Machine Learning.
Módulo 3. Machine Learning en Microsoft Fabric con Spark
Descripción
Este módulo aborda las principales consideraciones para desarrollar modelos de Machine Learning en Microsoft Fabric utilizando capacidades distribuidas de Apache Spark.
Se analizará cuándo resulta conveniente trabajar con Spark en lugar de Pandas, cómo cambia el enfoque de preparación y entrenamiento al trabajar con grandes volúmenes de información y cuáles son las principales consideraciones de rendimiento, escalabilidad y diseño dentro de Fabric.
Temas a cubrir
- Consideraciones para desarrollar Machine Learning sobre Apache Spark en Microsoft Fabric.
- Diferencias entre Pandas y Spark para procesamiento, preparación de datos y entrenamiento de modelos.
- Uso de Spark DataFrames y procesamiento distribuido para escenarios de gran volumen.
- Consideraciones de escalabilidad, rendimiento y selección de herramientas para modelos de Machine Learning en Fabric.
Módulo 4. Entrenamiento, experimentación y gestión de modelos en Microsoft Fabric
Descripción
Este módulo aborda el desarrollo y gestión de modelos de Machine Learning dentro de Microsoft Fabric, partiendo de conjuntos de datos previamente preparados y considerando escenarios tanto tradicionales como distribuidos.
Los participantes conocerán cómo estructurar procesos de entrenamiento, comparar diferentes alternativas, registrar experimentos y administrar versiones de modelos mediante las capacidades de Data Science de Fabric y MLflow.
Temas a cubrir
- Entrenamiento y evaluación de modelos de Machine Learning en Microsoft Fabric.
- Experimentación, comparación de resultados y selección de modelos.
- Uso de MLflow para el registro de métricas, parámetros y ejecuciones.
- Registro, versionamiento y administración de modelos dentro de Fabric.
Módulo 5. MLOps, automatización y consumo de resultados
Descripción
El módulo final presenta los principios de MLOps aplicados a Microsoft Fabric y la integración de los diferentes componentes desarrollados durante el curso.
Los participantes conocerán cómo automatizar la ejecución de procesos de Ciencia de Datos, gestionar nuevas versiones de modelos, monitorear su comportamiento y disponibilizar los resultados para su análisis mediante Power BI.
Temas a cubrir
- Principios de MLOps y ciclo de vida operacional de modelos.
- Automatización y orquestación de procesos de Ciencia de Datos en Fabric.
- Monitoreo, actualización y gestión de versiones de modelos.
- Publicación y consumo de resultados mediante Lakehouse y Power BI.
Organiza
Linchpin People cuenta con un equipo de consultores y mentores altamente especializados con muchos años de experiencia en formación y consultoría de TI. Linchpin People proporciona servicios de consultoría para empresas en los siguientes temas Soluciones de Business Intelligence, Análisis de datos, Administración de información, Power BI, Machine Learning.
Somos socios de Microsoft en Data Analytics & Business Intelligence, tenemos la experiencia para implementar las soluciones empresariales para sus necesidades. Aproveche el análisis predictivo y prescriptivo con Power BI como solución de análisis de datos y front-end. Contáctenos al correo info@linchpinpeople.com
